Por que criei o DataProfile: limpando o peso dos notebooks e levando quatro escolas de visualização para o GitHub
Se você trabalha com ciência de dados, engenharia analítica ou pesquisa quantitativa, provavelmente já passou por uma situação curiosa ao abrir o próprio perfil no GitHub: você escreve dezenas de módulos em Python, consultas em SQL e pacotes em R ou Go, mas as estatísticas do perfil juram que 94% do seu trabalho é apenas Jupyter Notebook.
Essa distorção acontece por um motivo simples na forma como o GitHub Linguist mede os repositórios. Ele soma os bytes brutos de cada arquivo, sem separar o que é código-fonte do que é saída gráfica salva dentro do JSON de um .ipynb. Um único notebook exploratório com três gráficos do matplotlib convertidos em texto base64 e duas tabelas em HTML passa facilmente de 4 MB, enquanto 15 mil linhas de código limpo divididas em módulos .py, .sql e .go pesam menos de 500 KB. É parecido com pesar uma caixa de mudança onde você guardou seus cadernos junto com um bloco de granito: na balança, parece que a sua casa inteira é feita de pedra.
Mas você talvez pense: “Não basta limpar as saídas das células antes de subir o commit?”. Na teoria, sim; na prática, quem usa o GitHub para compartilhar análises exploratórias precisa deixar os gráficos renderizados justamente para que colegas, recrutadores ou orientadores consigam ler o resultado no navegador sem ter que baixar e rodar o ambiente inteiro.
Foi para resolver esse problema (e mais dois pontos que sempre me incomodaram nos geradores tradicionais de README) que construí o DataProfile, um projeto aberto escrito em Go que quero compartilhar com vocês hoje.
O que falta quando olhamos só para linguagens e commits do GitHub?
Quando alguém abre o portfólio de uma pessoa da área de dados, saber que ela programa em Python ou R diz muito pouco sobre o que ela de fato constrói. Um engenheiro de dados que estrutura pipelines em Polars, DuckDB e dbt usa a mesma linguagem de quem treina modelos em PyTorch e Scikit-Learn, porém o trabalho diário dos dois é bem diferente. Sendo assim, em vez de olhar apenas para a extensão do arquivo, o DataProfile varre os manifestos de dependências dos repositórios (pyproject.toml, requirements.txt, environment.yml, DESCRIPTION) e também verifica hábitos de engenharia que costumam passar batido: presença de arquivos de trava (lockfiles), suítes de teste, fluxos de integração contínua (CI) e Dockerfile.
Outro ponto é que o nosso trabalho raramente mora num lugar só. Boa parte dos experimentos, bases tratadas e participações em competições fica no Kaggle, enquanto pesos de modelos e aplicações interativas ficam no Hugging Face Hub. Deixar essas duas plataformas de fora acaba escondendo metade do portfólio de quem pesquisa ou trabalha na área.
Dessa forma, o motor em Go 1.23+ (feito apenas com a biblioteca padrão, sem dependências externas) consulta GitHub, Kaggle e Hugging Face Hub ao mesmo tempo, abre a árvore JSON dos arquivos .ipynb para descartar imagens base64 antes de contar o código (Notebook Deflation) e monta os resultados em SVG.
Como o painel summary se comporta nas quatro escolas de visualização?
Em vez de criar um layout único cheio de enfeites, preferi desenhar os painéis seguindo quatro referências clássicas da visualização de informações: Edward Tufte, Stephen Few, Alberto Cairo e Nigel Holmes. Para mostrar a diferença entre elas na prática, trouxe abaixo o painel summary.svg (o quadro que resume todo o portfólio em quatro quadrantes) gerado com os mesmos dados de exemplo para cada uma das quatro escolas.
1. Edward Tufte (tufte)
A primeira escola segue a ideia de razão tinta-dados de Edward Tufte em The Visual Display of Quantitative Information (1983): se uma linha ou moldura não carrega informação nova, ela sai do gráfico.
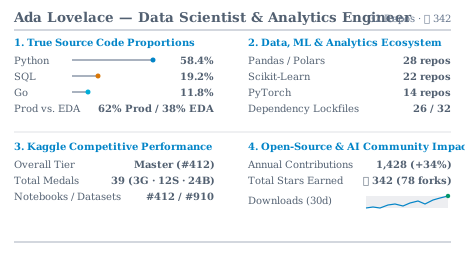
Painel summary.svg na gramática de Edward Tufte: sem caixas externas, com dot-dash plot, supertabelas em serifa tabular e sparkline com banda interquartil.
Repare que não há grade nem borda fechando o cartão. No primeiro quadrante, a proporção real de código (após limpar os notebooks) aparece num gráfico dot-dash: Python responde por 58,4%, SQL por 19,2% e Go por 11,8%, separando também o que é código de produção (62%) do que é exploração em notebooks (38%). Os demais quadrantes usam supertabelas alinhadas com numerais tabulares e fecham, no canto inferior direito, com uma sparkline acompanhada da faixa interquartil cinza para a série de downloads dos últimos 30 dias.
2. Stephen Few (few)
A segunda opção vem de Information Dashboard Design (2006), do Stephen Few, pensada para que um leitor bata o olho e entenda os indicadores principais em três segundos.
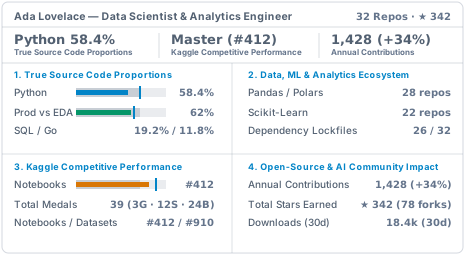
Painel summary.svg na gramática de Stephen Few: faixa superior de indicadores (KPIs) e bullet graphs com bandas qualitativas e marcador vertical de referência.
Essa estrutura abre com uma faixa superior que entrega de imediato os três números centrais do perfil (Python 58.4%, Master (#412) no Kaggle e 1,428 (+34%) contribuições no ano). Abaixo dela, entram os bullet graphs criados pelo próprio Few: barras horizontais enxutas que correm sobre faixas qualitativas de fundo e trazem um traço vertical indicando a meta ou referência de comparação.
3. Alberto Cairo (cairo)
Para quem prefere uma pegada editorial próxima do jornalismo de dados, a terceira escola bebe em The Functional Art (2012) e The Truthful Art (2016), do Alberto Cairo.
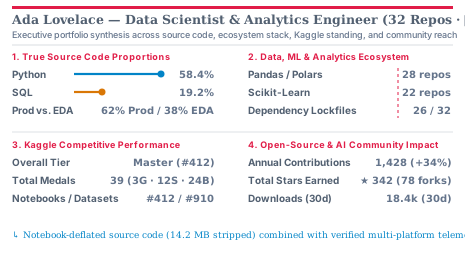
Painel summary.svg na gramática de Alberto Cairo: régua carmesim, gráficos lollipop com linha tracejada de referência e camada de anotação explicativa no rodapé.
Aqui o painel ganha uma régua superior carmesim, título e subtítulo que explicam o recorte do quadro, gráficos lollipop no primeiro quadrante e uma linha vertical tracejada no segundo para situar os 28 repositórios com Pandas / Polars e os 26 com lockfiles frente ao total de 32 projetos. O detalhe que mais gosto nessa escola está na última linha (↳): uma nota de rodapé que conta explicitamente quantos megabytes de imagens base64 foram podados na normalização (14,2 MB nesse exemplo).
4. Nigel Holmes e ISOTYPE (holmes)
Por fim, se a ideia é ter um painel mais visual e direto, a quarta escola combina o estilo de infográficos de revista do Nigel Holmes (Designer’s Guide to Creating Charts and Diagrams, 1984) com o sistema pictórico ISOTYPE de Otto Neurath.
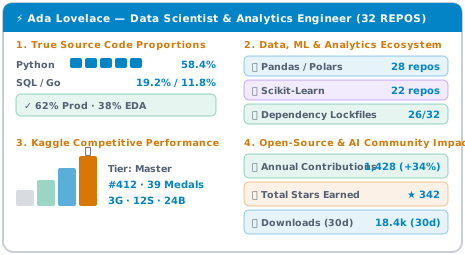
Painel summary.svg na gramática de Nigel Holmes e ISOTYPE: blocos unitários de 10%, selos de ferramentas e pódio em degraus para a progressão no Kaggle.
Em vez de linhas finas, a fatia de Python aparece como blocos físicos (onde cada peça equivale a 10% do código), as ferramentas e métricas de comunidade entram em cartões emoldurados e o desempenho no Kaggle é desenhado como um pódio em degraus mostrando a caminhada até o nível Master (#412, com 3 medalhas de ouro, 12 de prata e 24 de bronze).
Como testar no seu perfil (e onde conversar sobre o projeto)?
Além do summary.svg, cada execução do DataProfile gera outros oito painéis (languages.svg, stack.svg, kaggle.svg, impact.svg, header.svg, bio.svg, bio-full.svg e full.svg) nas quatro escolas, somando 36 arquivos SVG com fundo transparente e cores calibradas para funcionar tanto no tema claro quanto no tema escuro do GitHub. Você pode escolher uma única escola para o seu README inteiro ou misturar painéis de escolas diferentes.
Para ninguém precisar sujar o histórico de commits da branch principal só para atualizar número de estrelas ou posição no ranking, o fluxo no GitHub Actions publica todas as imagens numa branch órfã chamada output. Basta fazer um fork do repositório (ou chamar a Action diretamente no seu repositório <usuario>/<usuario>) e apontar as tags <img> do seu perfil para lá.
Se você quiser testar no seu GitHub, ver como foi montada a arquitetura ou sugerir melhorias, deixo abaixo os links principais:
- Repositório oficial e guia de configuração: github.com/pablodiegoo/dataprofile
- Ficha técnica detalhada aqui no portfólio: /projects/dataprofile/
- Post e conversa aberta lá no Kaggle: kaggle.com/discussions/general/754125
Acredito que ainda há bastante espaço para evoluir os coletores e os detalhes visuais de cada escola, mas o motor já resolveu de vez aquela distorção dos notebooks que me incomodava há tempos. Se você testar por aí ou quiser trocar uma ideia sobre visualização de dados, passa lá no tópico do Kaggle ou abre uma issue no GitHub que vai ser um prazer conversar!
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Drivers Setoriais de Avaliação Municipal, Tarifa Zero e Moeda Social
- Economia Comportamental Fiscal e o Fenômeno da Desinformação Punitiva no IPTU
- Engenharia Geoespacial e Auditoria de Qualidade de Dados Turísticos (EMPETUR)
- Diagnóstico Operacional e Estratégico de Vendas em Marketplaces Digitais (OS 18)
- Consultoria de Especialização Segmentada de MPEs (OS 15)
- Modelagem Econométrica de Desaprovação Governamental
- Pesquisa Qualitativa de Percepção dos Serviços de Saúde Pública
- Criptomoedas: Mas Seria o Bitcoin Efetivamente uma Moeda?
- Criptomoedas: A Expansão de um Mercado